周苍田

Zhou Cangtian

具身智能算法工程师

VLA / WAM / 机器人学习

GitHub / Dev-EmbodiedAI ↗

3 段产业实习 · 多模态理解 / 机器人控制 / 世界模型

01 / 教育背景

教育背景

哈尔滨工业大学校徽

哈尔滨工业大学

Harbin Institute of Technology · 2020 — 2027

硕士 · 控制科学与工程(推免)
2027 届
本科 / 硕士 GPA
91.51 / 85.08
本科阶段
2020 — 2024
个人信息
2003.09 · 中共党员

奖项

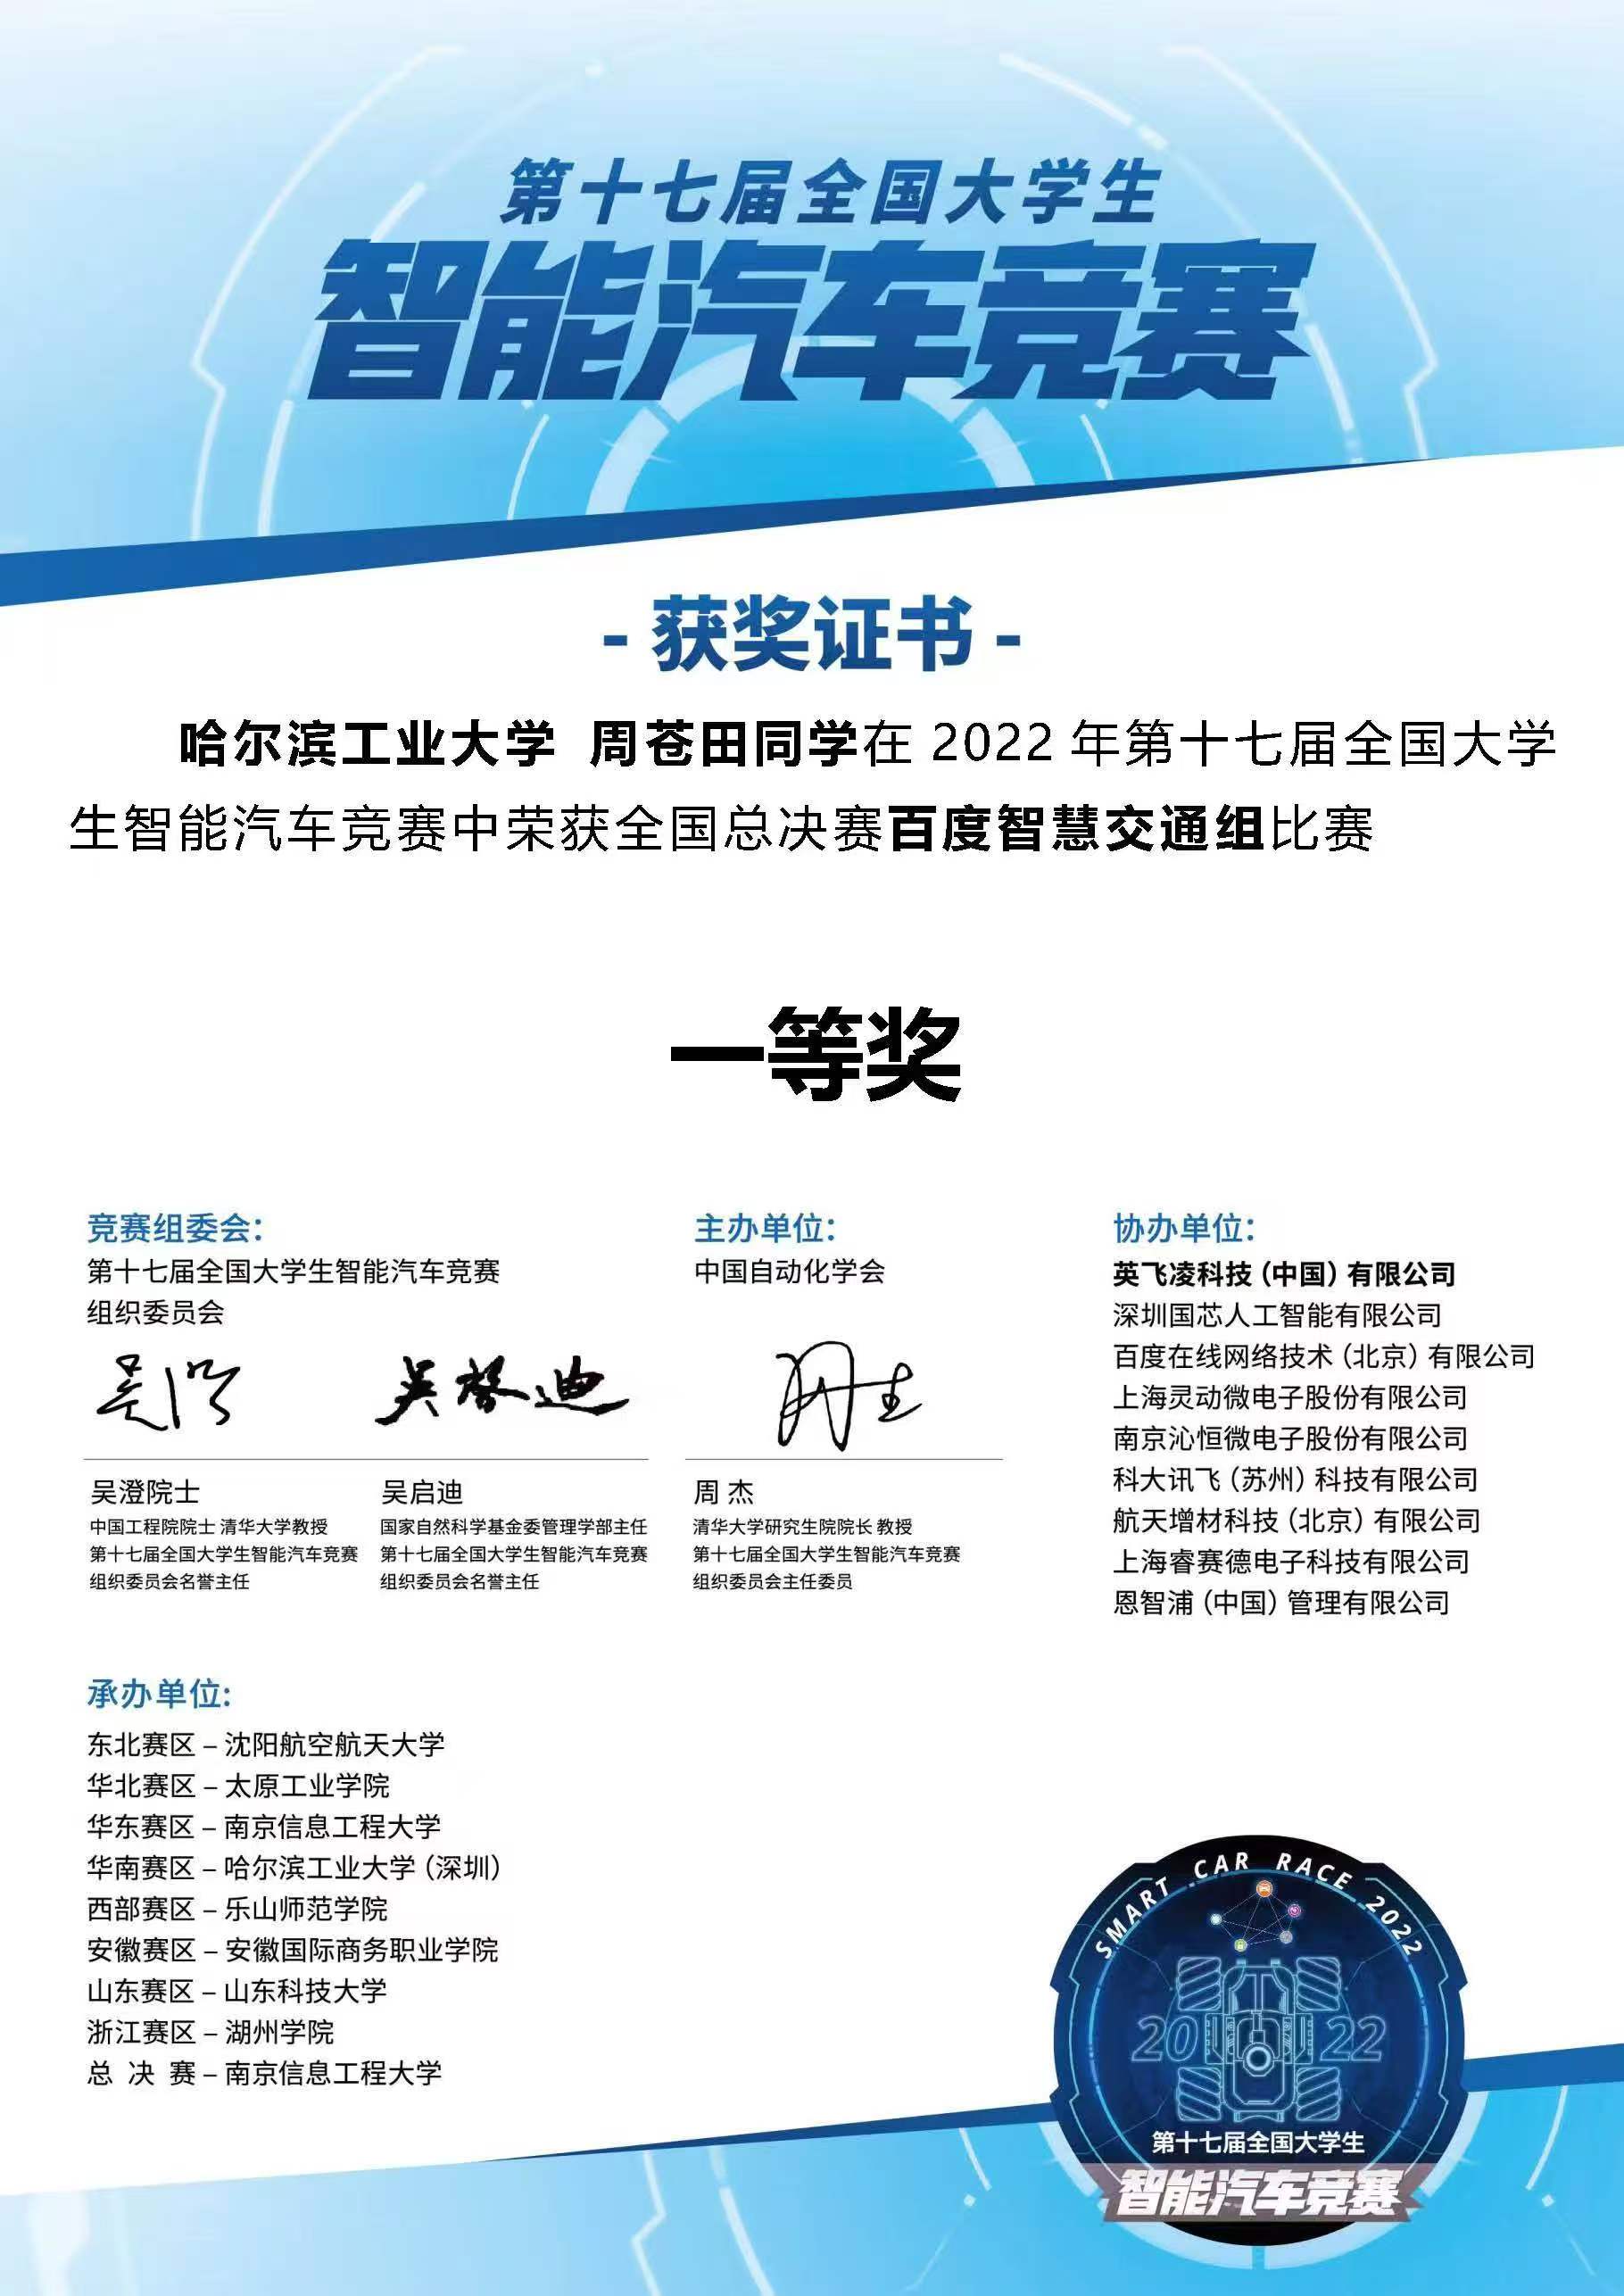
全国一等奖

第 17 届全国大学生
智能汽车竞赛

百度智慧交通组 · 全国总决赛

第17届全国大学生智能汽车竞赛全国一等奖证书
获奖证书 · 点击放大
02 / 论文

论文

视觉感知、工业缺陷检测、具身多模态理解

01

From Isolated Views to Holistic Logic: Learning Joint Multi-Scene Understanding for Embodied AI with Vision-Language Models.

AAAI 2027CCF-AHUGIN

共同第一作者在投

02

OpenMorphoQuery: From Visual Morphology Prompts to Target-Grounded Queries for Unseen Industrial Defect Localization.

ICLR 2027CCF-A

第三作者在投

03

A robust defect detection method with a generalization enhancer and cross-modality aggregator for cylinder bores.

EAAI 2024CCF-C

第三作者

04

RoMATer: An end-to-end robust multiaircraft tracker with transformers.

IJCNN 2024CCF-C

第三作者

03 / 实习经历

实习经历

01 / HUGIN · 京东 X 科技部
HUGIN 多相机观测、VLM 规划与机械臂控制系统架构
多视角局部观测 → 联合场景理解 → 机械臂动作规划

HUGIN:跨视角物流分拣

面向多格口、多笼车的物流分拣,结合 EDA 数据扩增、GCR 全局上下文排序损失与辅助感知监督,提升跨视角 VLM 决策准确率。

78.8%SortingBench 准确率
+15.2 个百分点相对 SFT 提升 23.9%
VLM / Qwen3-VLGCR · 零推理开销AAAI 2027 在投 · 共同一作
深入了解 HUGIN:任务场景、数据扩增与完整实验

任务背景:多格口 × 多笼车的复杂分拣

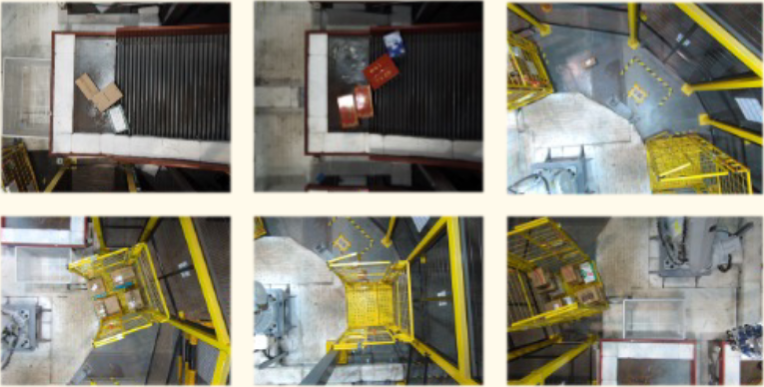
京东物流单臂需同时服务 2+ 分拣格口 × 4 笼车,每个相机只能看到局部场景,跨视角互补观测是核心挑战。
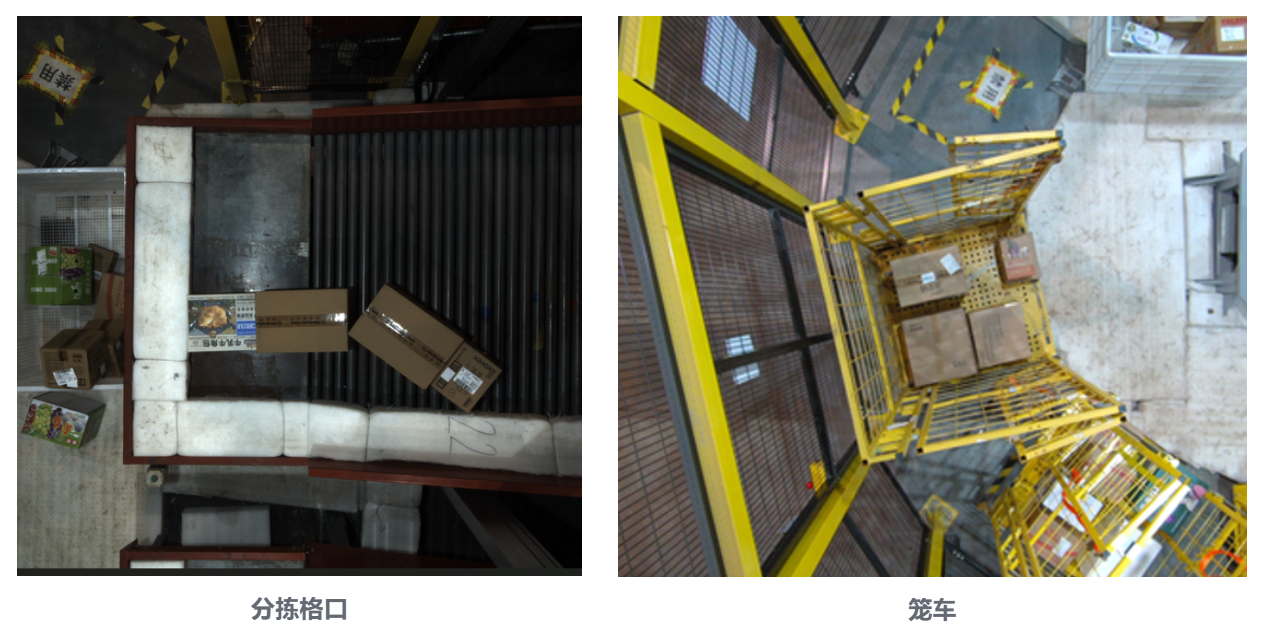
实拍:分拣格口与笼车,包裹杂乱
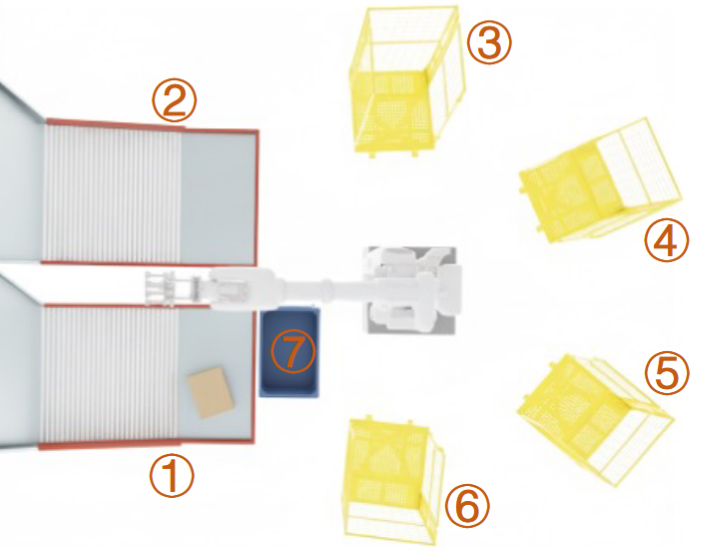
俯视布局:2 格口 × 4 笼车 × 暂存区
多相机跨视角观测
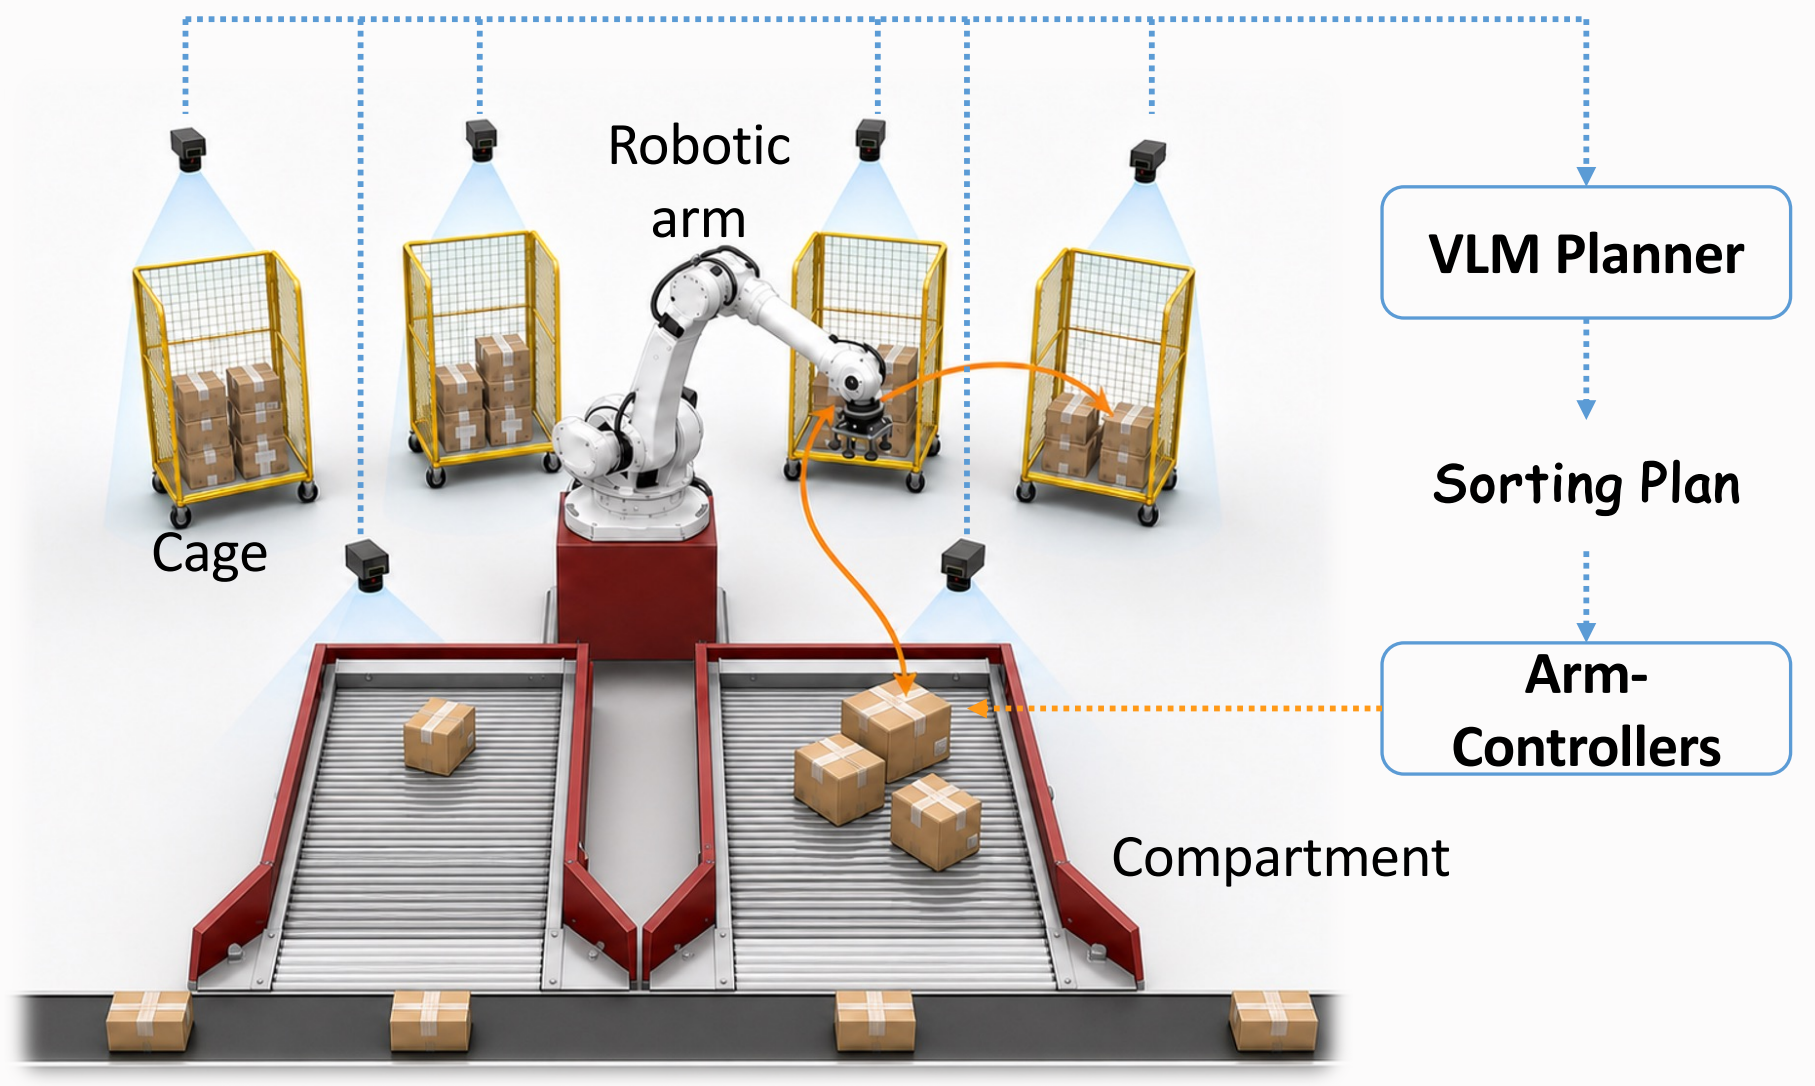
系统架构:多相机 → VLM Planner 输出分拣计划 → Arm-Controllers 执行
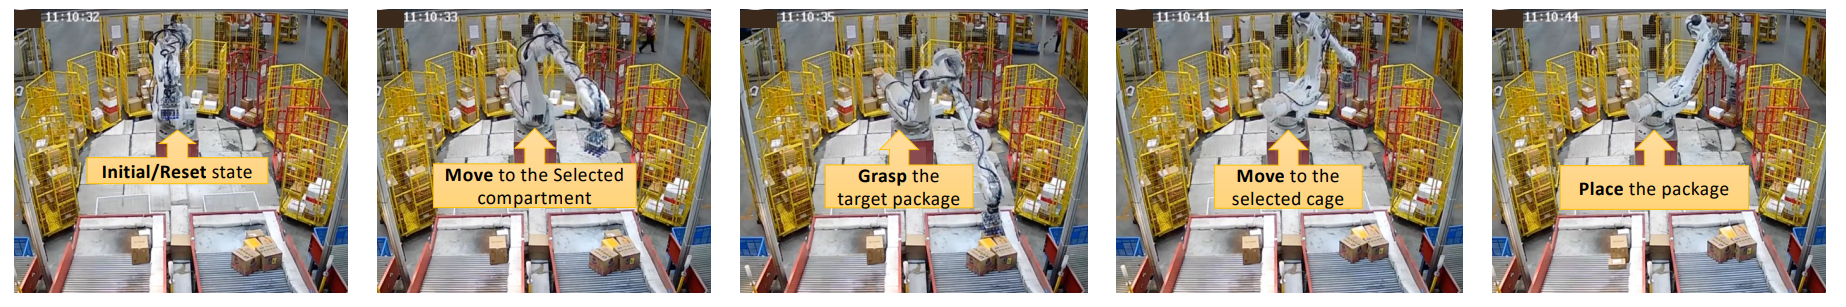
产线实录:Reset → Move(格口) → Grasp → Move(笼车) → Place 完整动作序列

方案一:EDA 数据扩增(2k → 2.6w)

原始人工标注仅 2000 条,直接 SFT 严重不足。设计三阶段数据扩增:
2k
原始样本
→
6k
子任务拆分
sub-task VQA
+
2k
重组 task
+
1.4w
辅助感知
YOLO/SAM3 生成
+
4k
通用 VQA
防过拟合
→
2.6w
训练数据
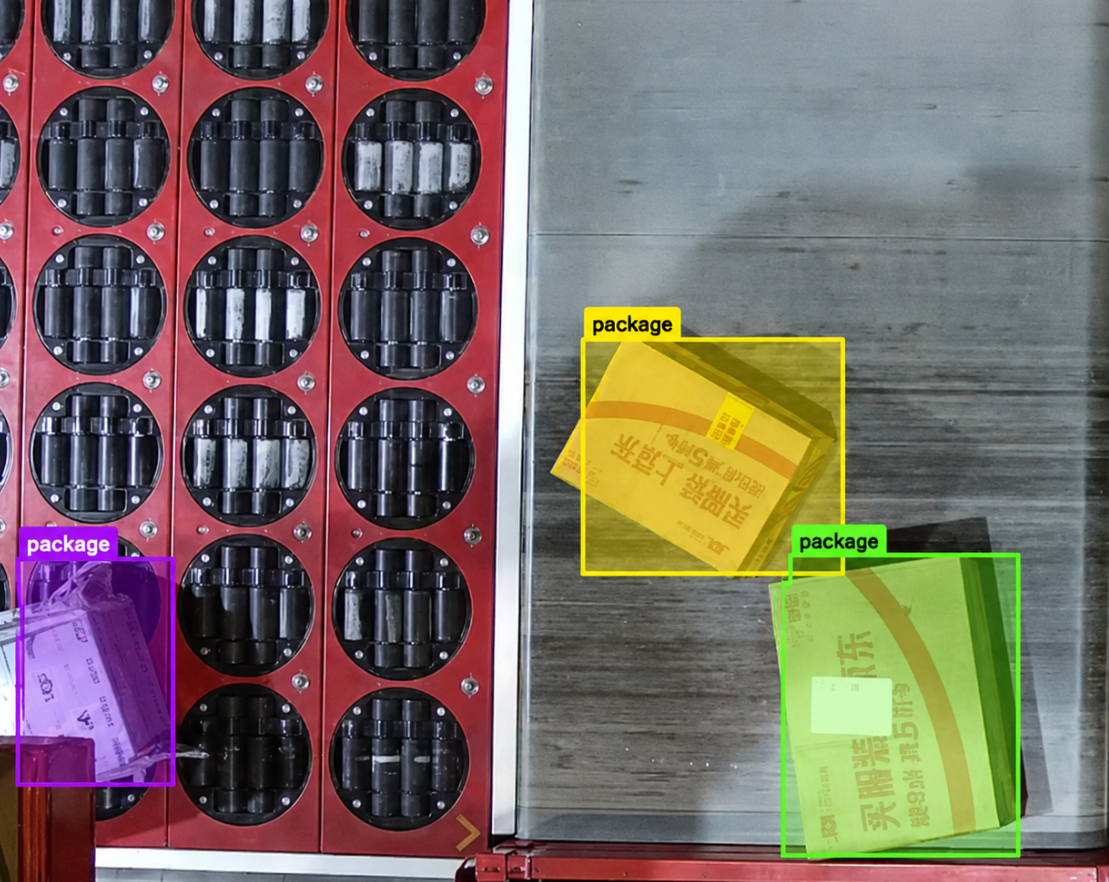
辅助感知:YOLO 生成包裹检测 VQA,抑制小目标定位幻觉
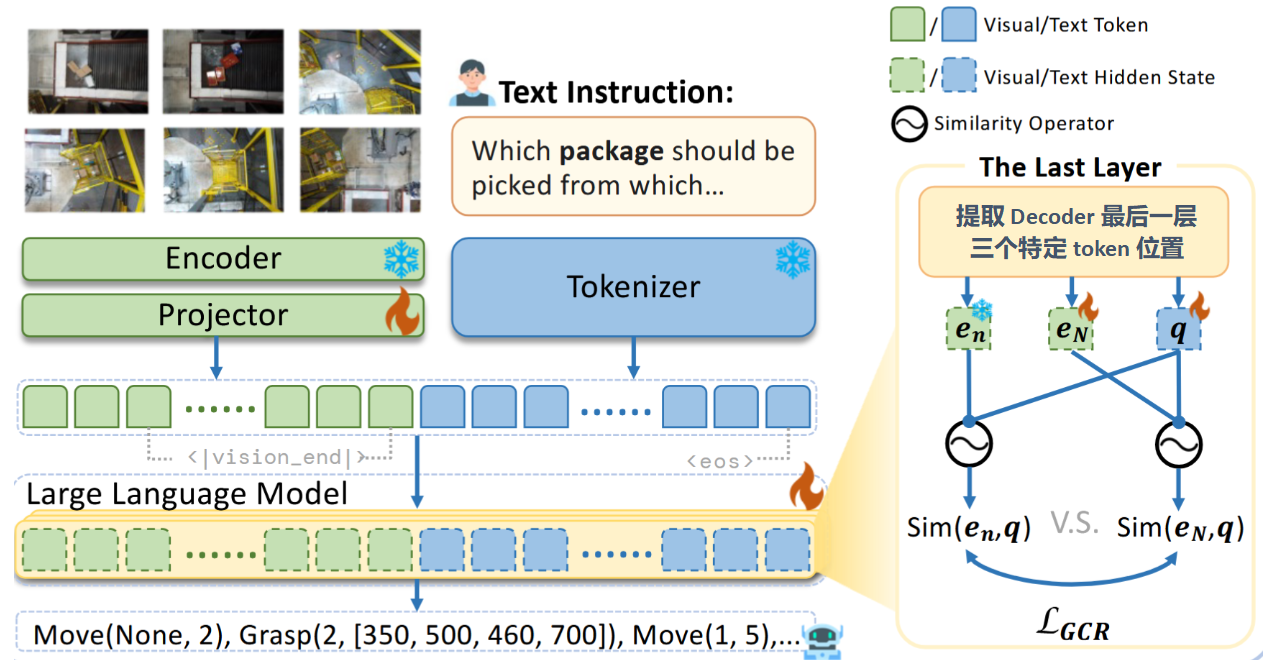
HUGIN 核心架构:Encoder → Projector → LLM 生成动作,同时算 GCR 对比损失

方案二:GCR Loss — 强制利用全局多图上下文

SFT 易让模型只看单图作答。引入 Global Context Ranking Loss:要求"含全部视角"的输入比"含部分视角"产生更高的指令相似度,零推理开销。

GCR 损失

𝓛GCR = 𝔼n~𝒰{1,N-1}[ max(0, α + SG(ẽn)ᵀq̃ − ẽNᵀq̃) ] ,全局上下文相似度须高于部分上下文,margin=α

方法SortingBench 准确率说明
Base(零样本 Qwen3-VL)0%完全无法完成
SFT(仅 2k 原始数据)63.6%基线微调
HUGIN(EDA + GCR + 辅助感知)78.8%相对 SFT +23.9%
关键结论

GCR 零推理成本;EDA 在数据受限时增益显著;辅助感知监督解决小目标定位幻觉。方法在 Ovis2.5-2B / Gemma3-4B / MiniCPM-V4.5 上均验证有效。
02 / CoPack · 京东 X 科技部
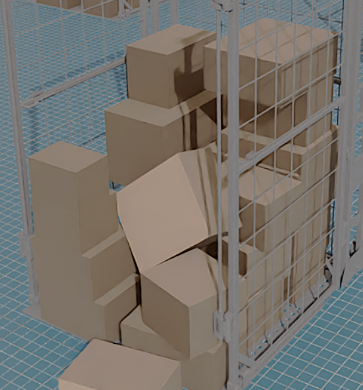
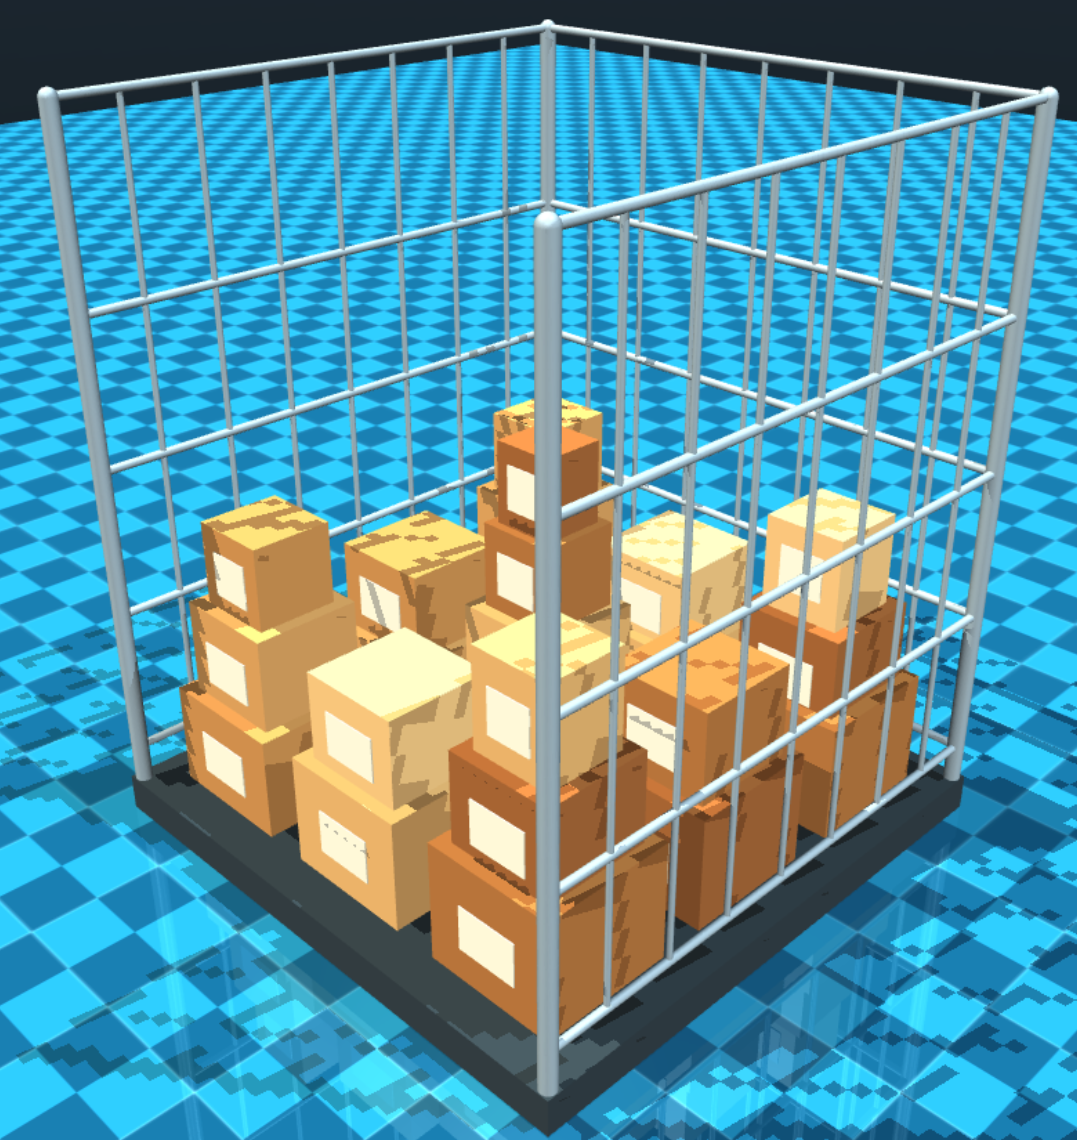
CoPack 在线三维装箱与机械臂码垛仿真场景
以物理稳定性约束连接仿真训练与产线码垛

CoPack:强化学习码垛

以 GAT 图编码器和 ACKTR 策略处理在线三维装箱,通过静态预训练、域随机化仿真强化学习与真实轨迹微调,完成 Sim2Real 部署。

35.2% ↓物品塌落率相对降低
7.31 → 4.74%部署前后 ICR
GAT / ACKTRMuJoCoABB 工业机械臂
深入了解 CoPack:MDP 设计、Sim2Real 流程与部署结果

在线三维装箱 + 物理稳定性约束

包裹逐个到来,每步决策放入笼车最优位,最大化体积利用率同时避免倒垛。难点:变长动作空间 + 真实物理稳定性 + sim2real gap。
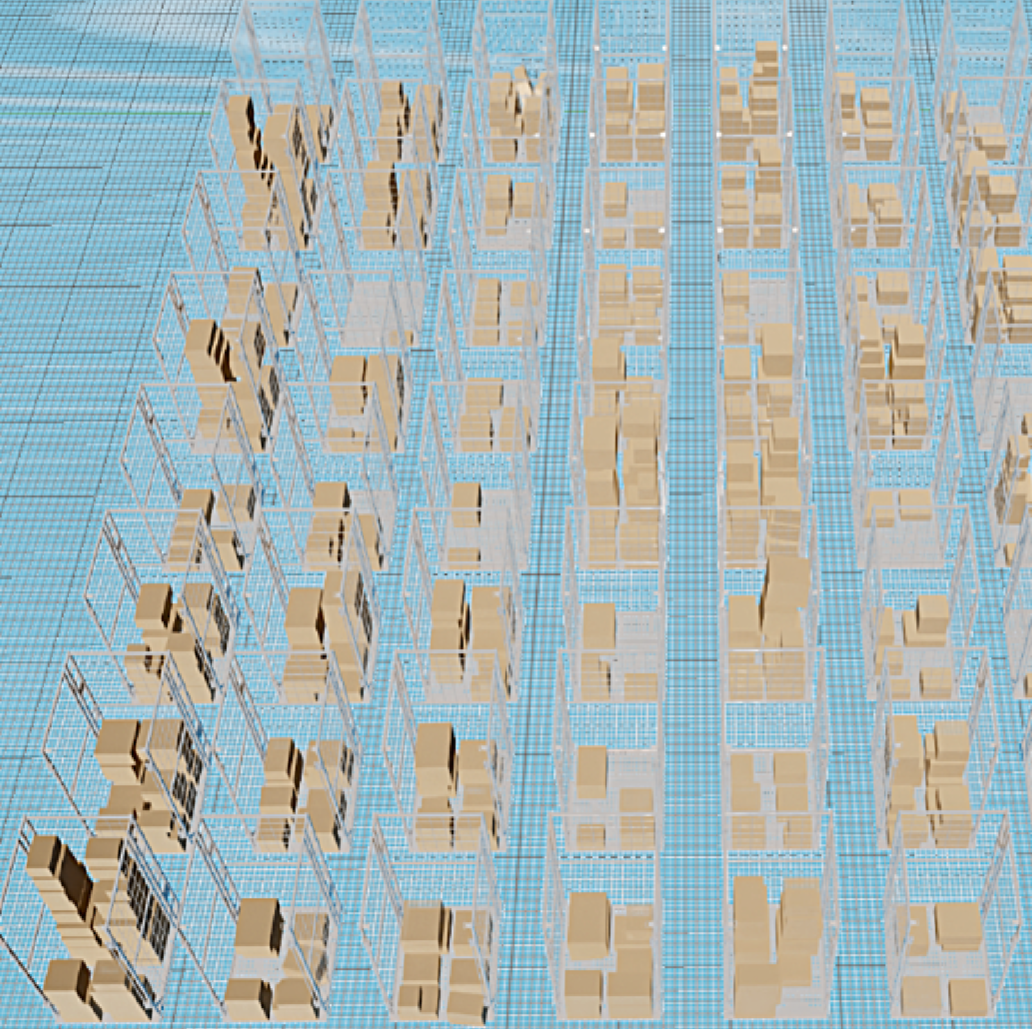
MuJoCo 仿真:整齐码放
大规模并行训练环境
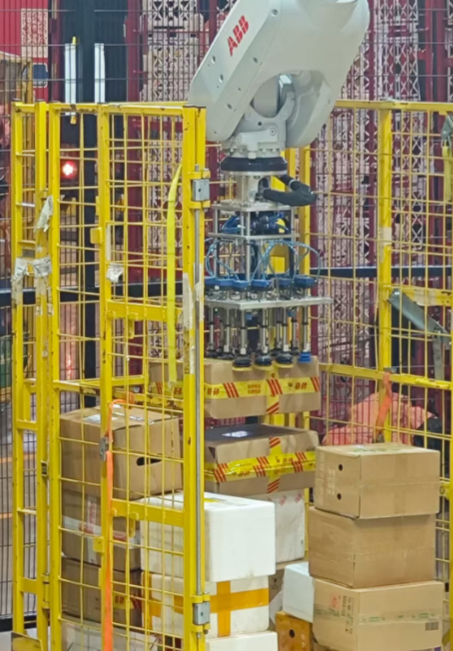
真实部署:ABB 工业机械臂产线

GAT 编码器 + ACKTR Actor-Critic

GAT 图编码:三类异构节点注意力聚合,学习支撑/稳定关系
MDP 设计
  • State:已装包裹 + 候选位 + Next Item 尺寸
  • Action:从 EMS 候选位选一个(+朝向)
  • Reward:成功→体积;倒垛→终止清零
三阶段 Sim2Real
静态预训练
离线数据学基础策略
→
仿真 RL
MuJoCo + 域随机化
重量/重心/摩擦
→
真实微调
结合产线倒垛轨迹
指标部署前部署后变化
物品塌落率 ICR7.31%4.74%↓ 35.2%
03 / Cross-Embodiment VLA · 无界动力
piper 与 DOS-W1 的跨本体动作空间对齐及混合训练架构
UnifiedEEF:统一动作表征,连接不同机器人本体

π0.5:跨本体 VLA 混训

基于 π0.5 联合训练 piper 与 DOS-W1 数据,完成 UnifiedEEF 坐标对齐、多尺度记忆及 FAST CE 消融。建立 7 任务 / 146h 的统一多任务 benchmark。

5 / 31RoboChallenge Table30-v2 双臂
93%放碗泛化成功率 · 15 次真机测试
π0.5 / UnifiedEEFMemory / Flow Matching排名截至 2026.07.14
深入了解 VLA:跨本体混训、消融实验与 RoboChallenge 评测

跨本体 Co-Train:piper + DOS-W1 混训

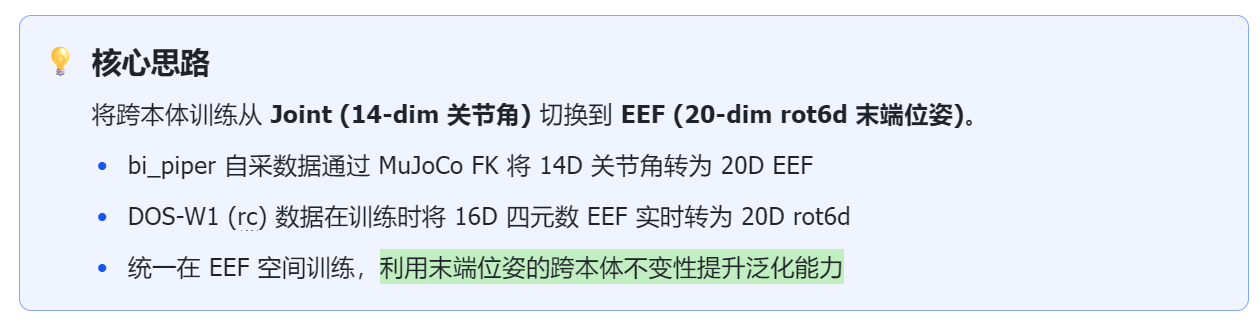
自采 piper 数据与 DOS-W1 数据融入 π0.5 跨臂型混训,核心是 UnifiedEEF 动作空间对齐——EEF 增量从基座坐标系变换到相机坐标系,确保同一物理运动跨数据集数值接近。

跨本体动作空间统一:Joint 14-dim → EEF rot6d,统一表征后混训
数据集Cross-EmbBipiperMulti-Joint
v0620.14.96.228.7
v0620.24.66.012.3
v0621.10*6.36.821.8
v0622.1*8.16.626.3
原汇总值*7.27.619.2

开环 MSE;数据集名称后的 * 为 held-out 泛化集。末行保留原记录汇总值,统计范围待核,并非上方 4 行的算术均值。

真机 · 放碗 15 次泛化
  • Multi-Task Joint:33%
  • Bipiper EEF:80%
  • Cross-Emb EEF:93% ← UnifiedEEF 是关键

无坐标对齐时混训性能崩溃至 0%。

子模块消融

Memory 多尺度记忆 arxiv:2603.03596 ↗

5 帧历史 + SigLIP 每 4 层 ViT 插时间注意力。真机总成功率 86.5% → 88.5%(+2.0 个百分点),复杂任务收益明显。
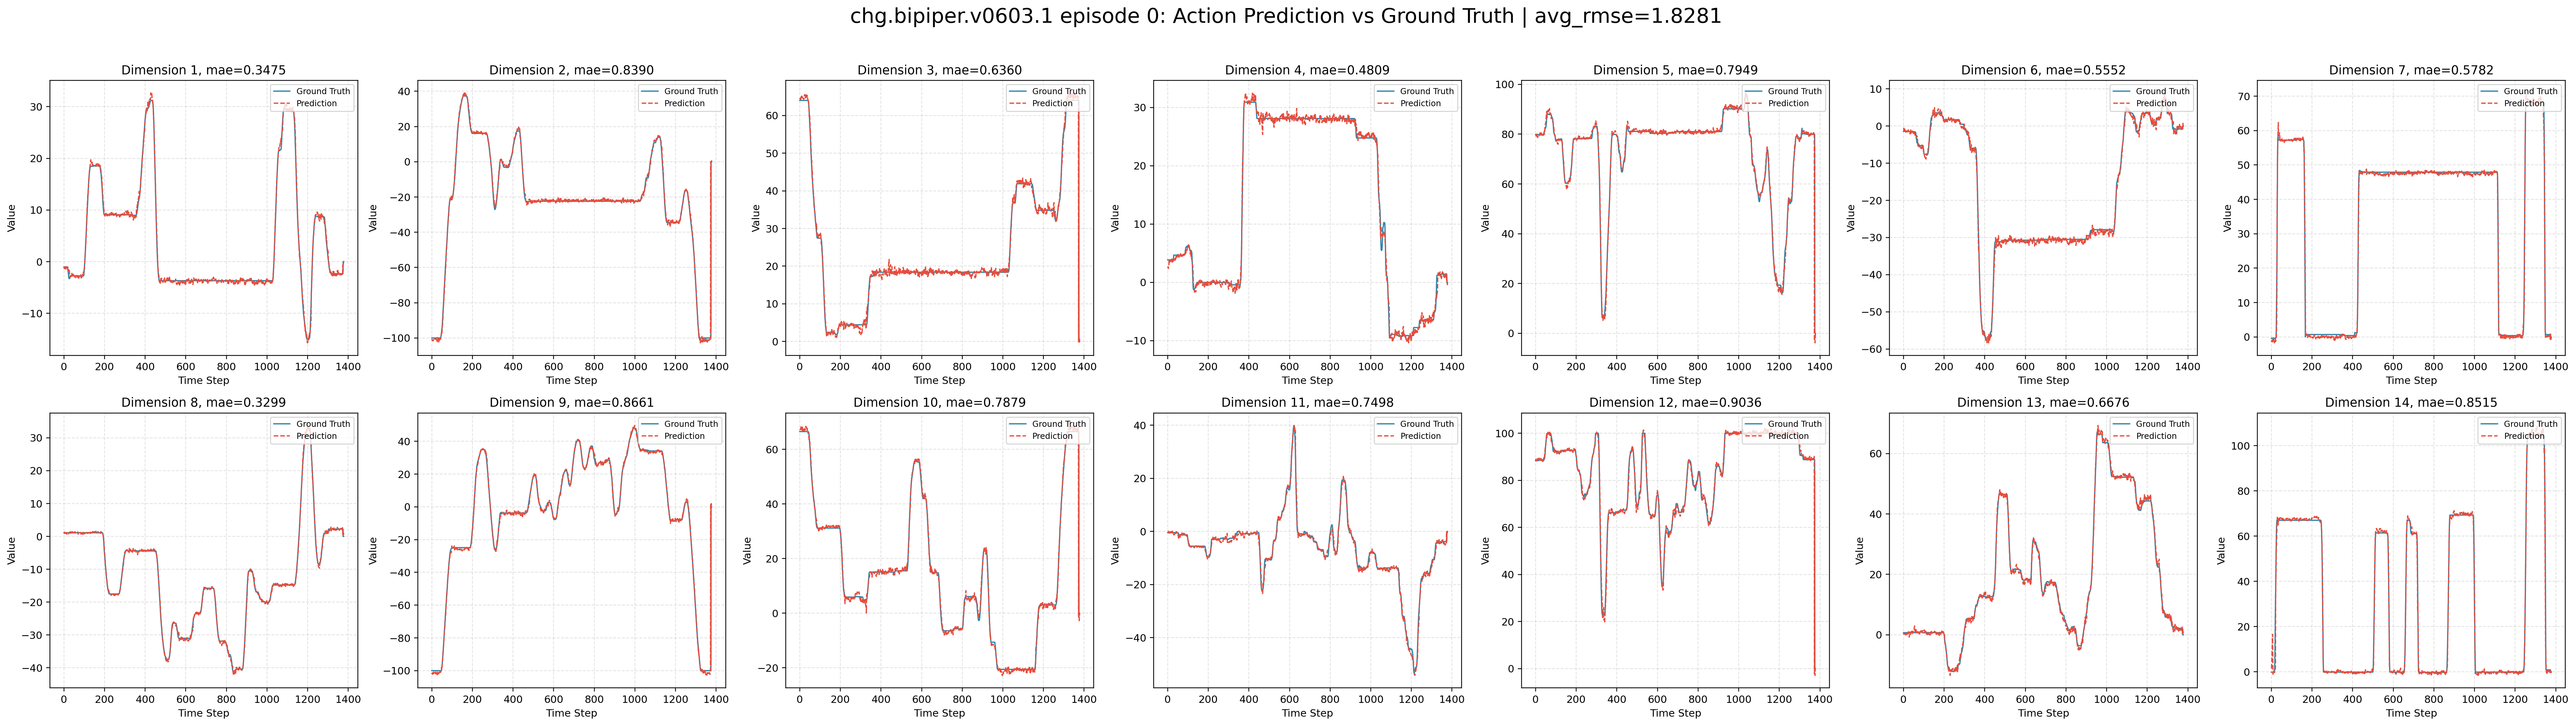
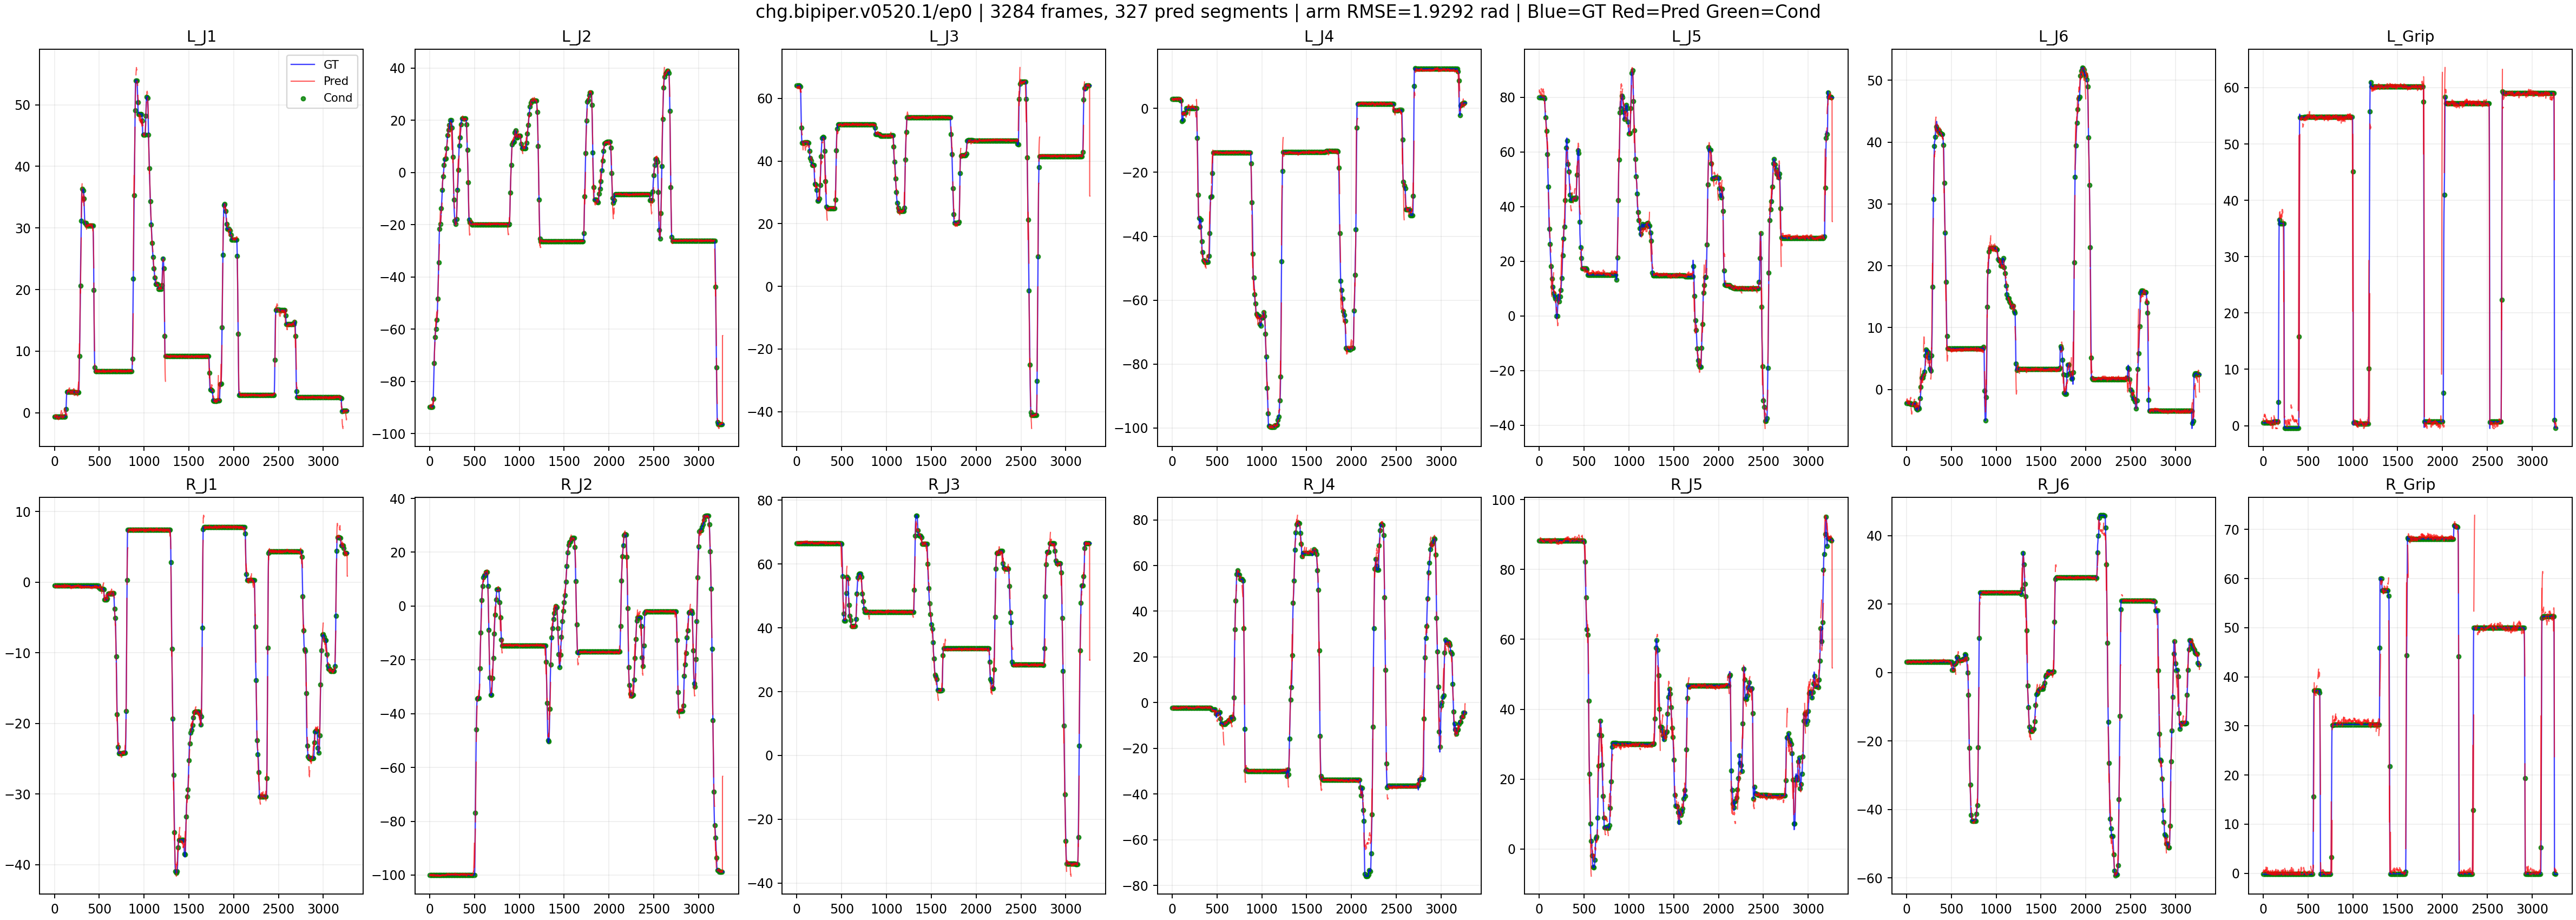
FAST CE vs 纯 Flow Matching arxiv:2505.23705 ↗

KI 梯度隔离防 FM loss 污染 VLM。结论:多任务场景 FAST CE 相较纯 FM 未见整体收益,多数任务 MSE 上升——精细连续控制下 FM 更稳健。
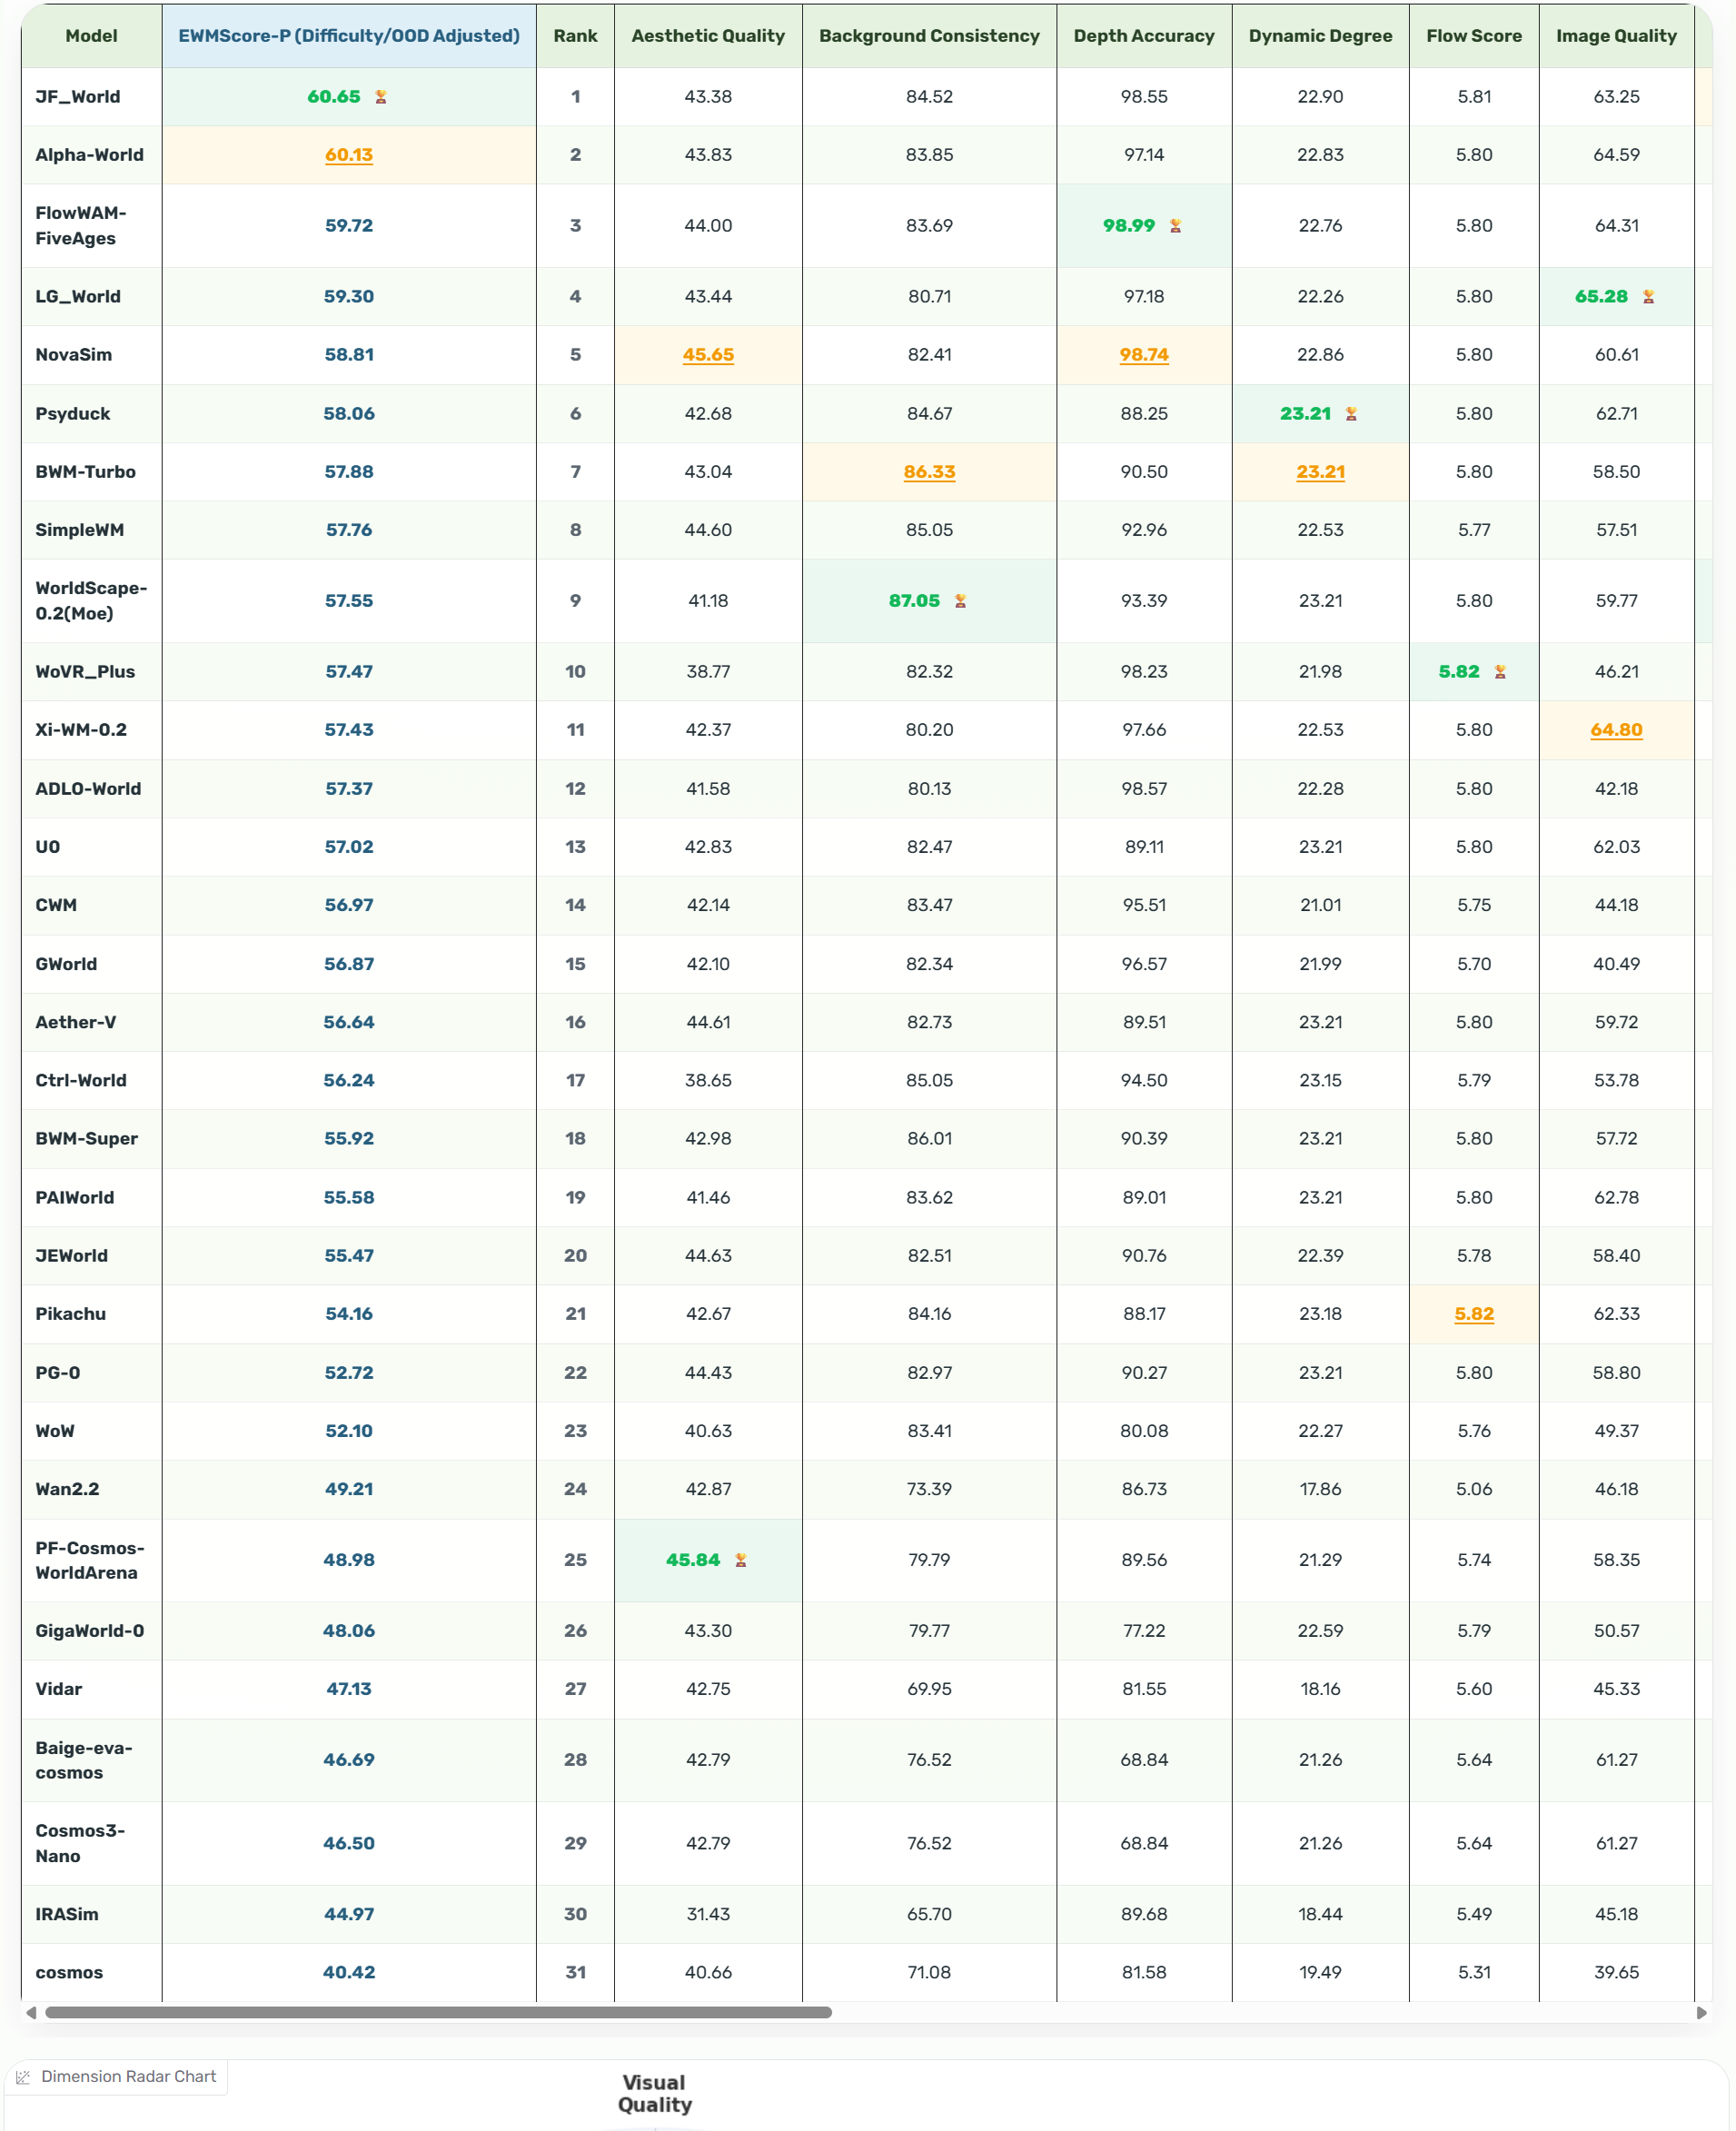
RoboChallenge Table30-v2 打榜

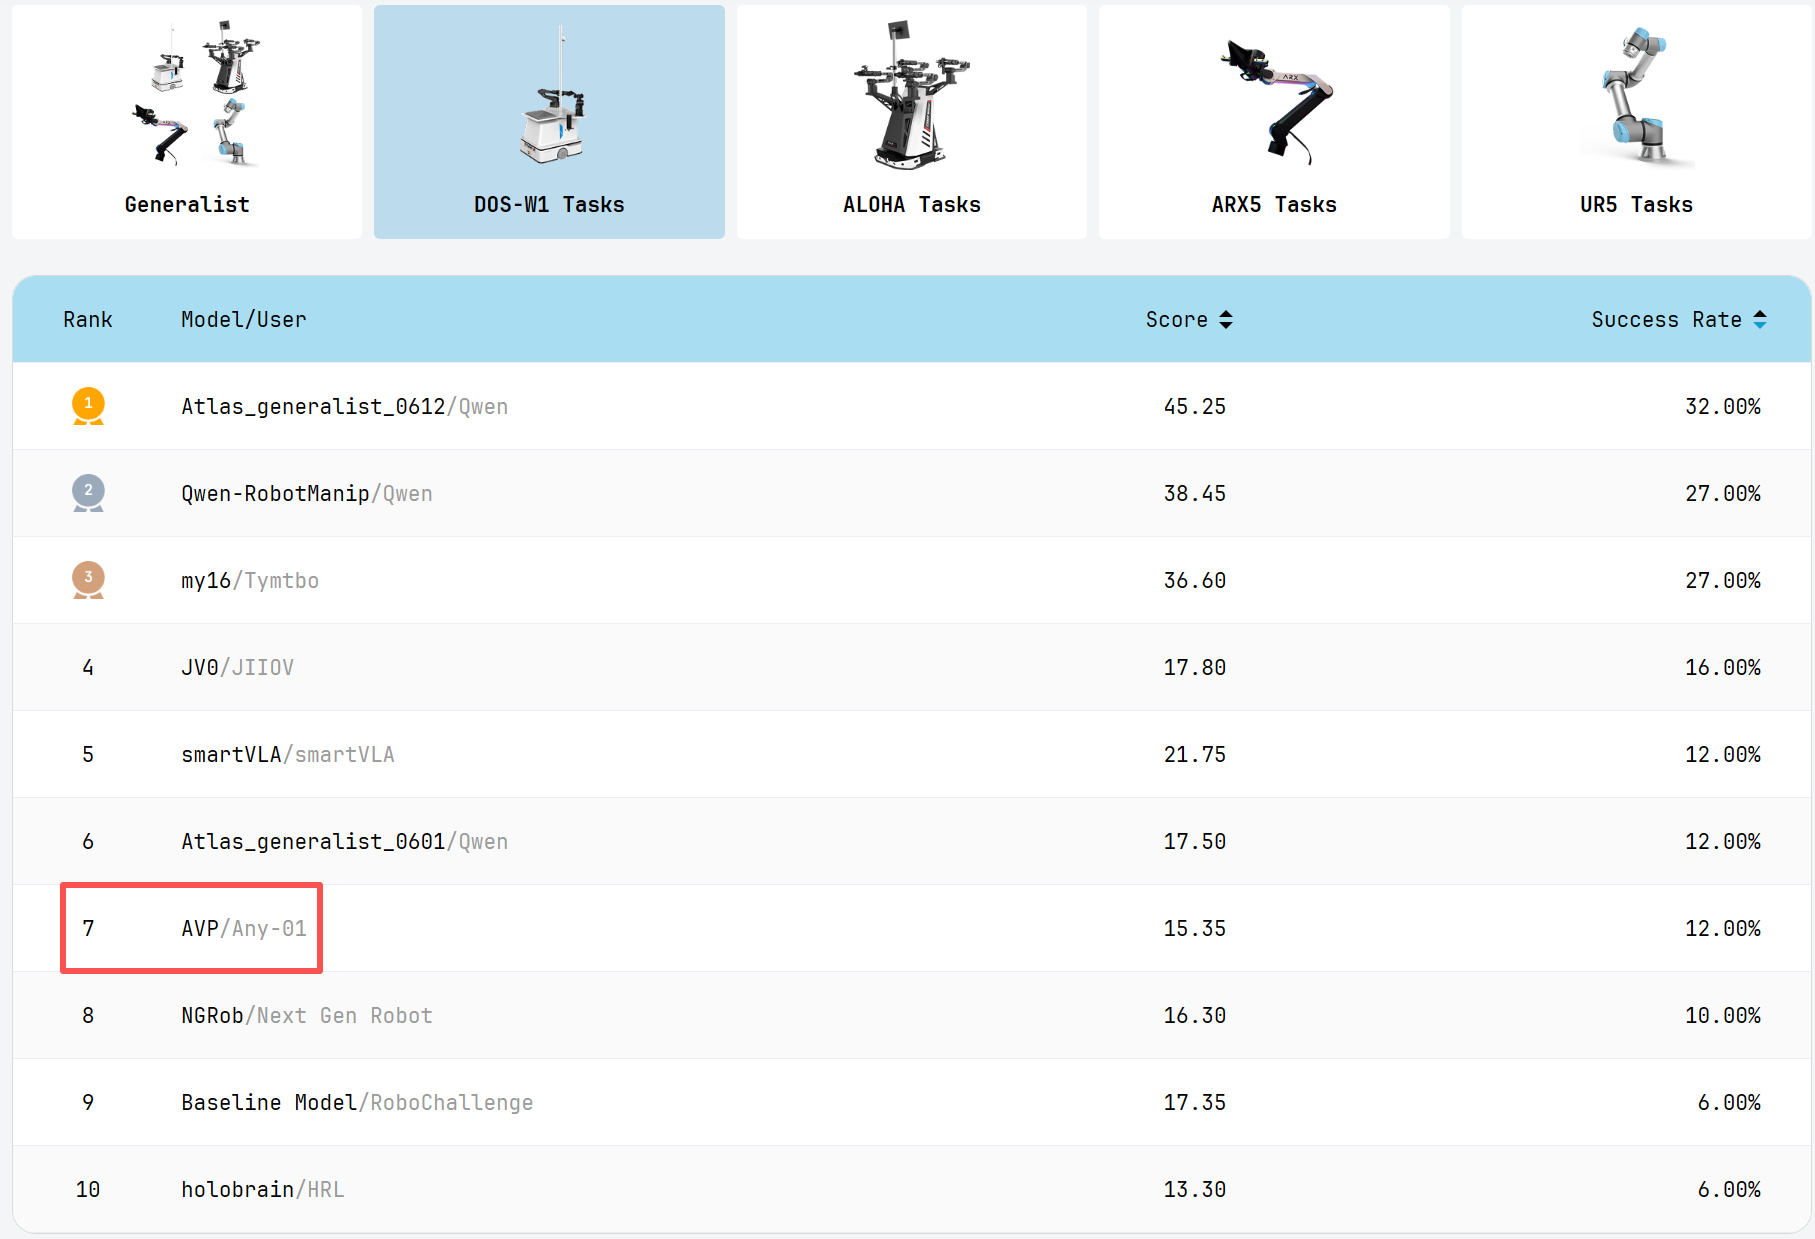
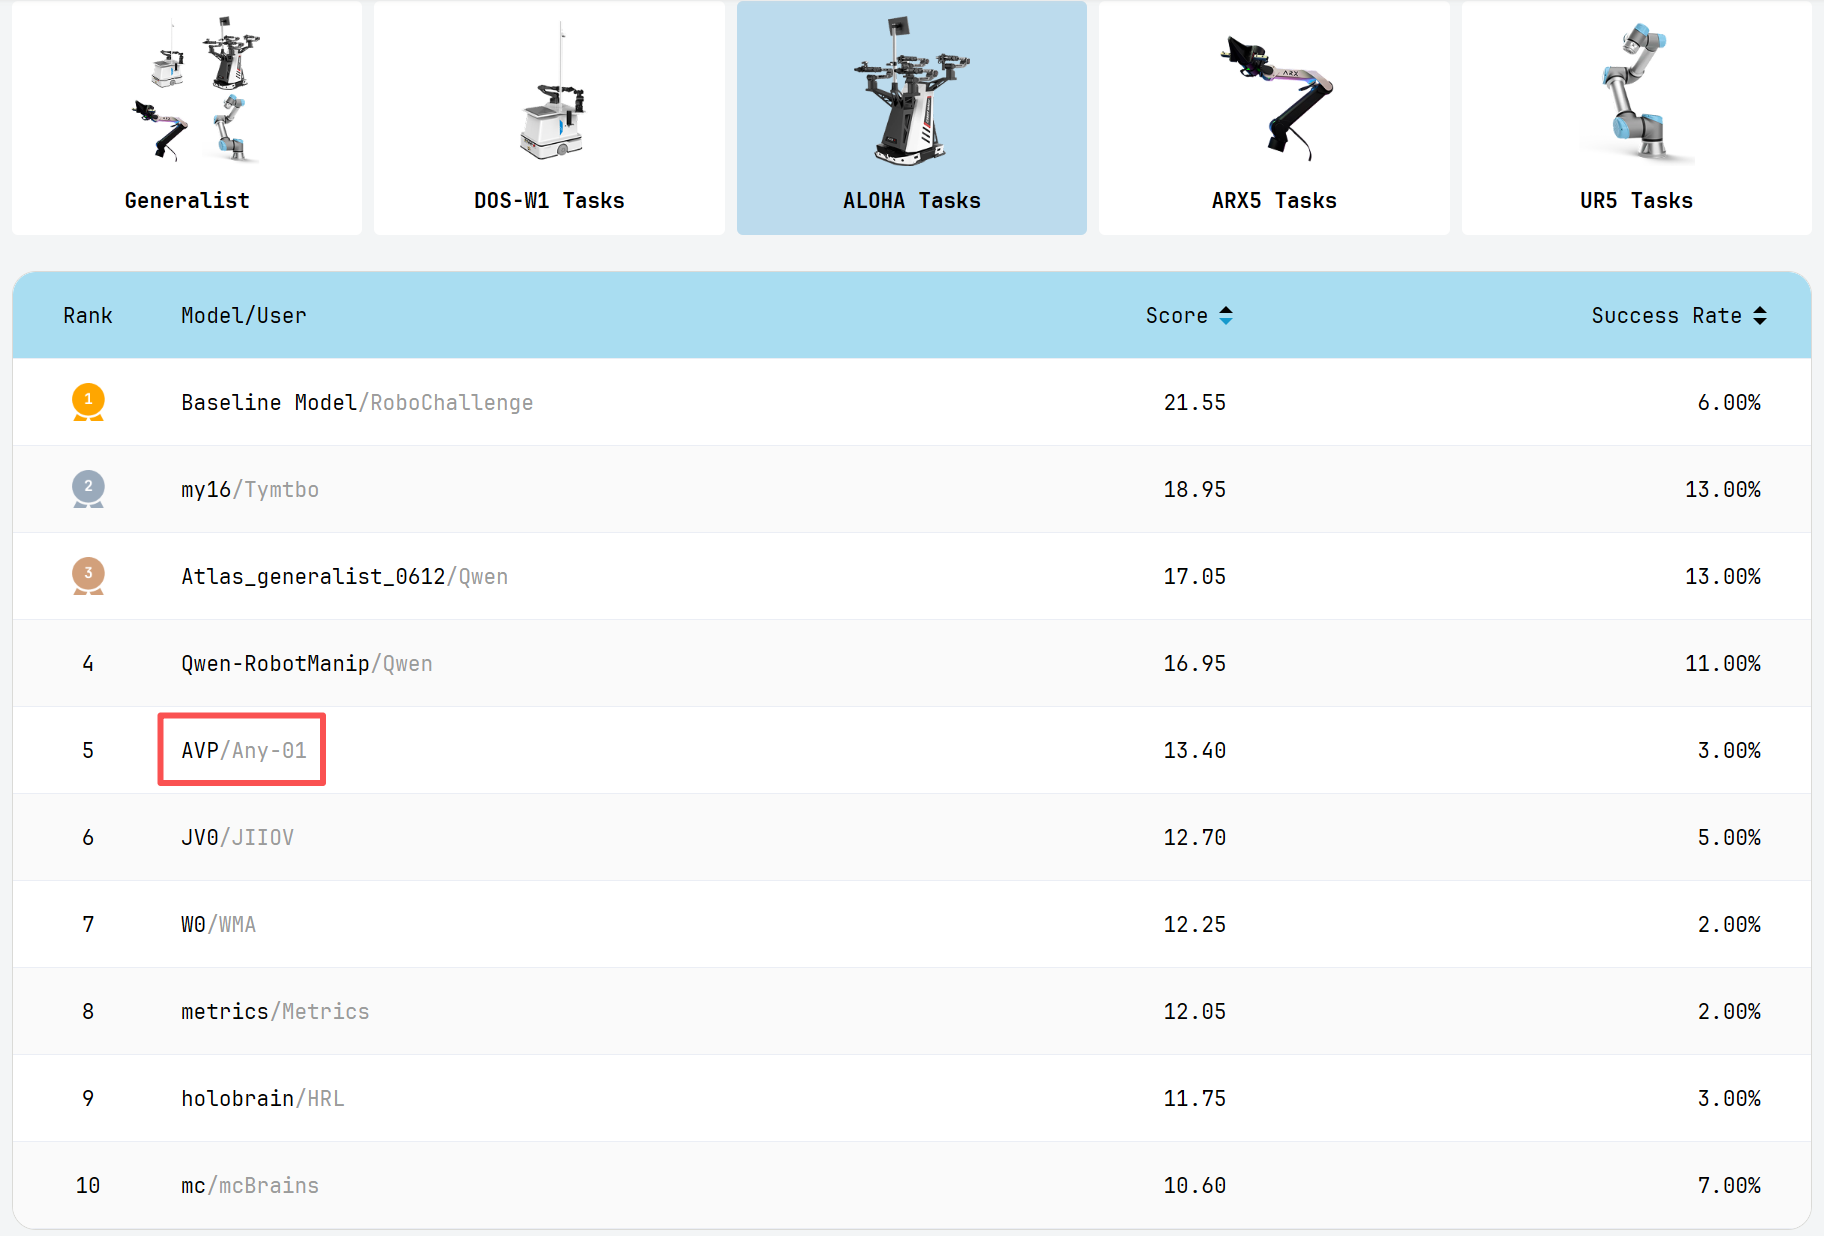
排行榜(截至 2026.07.14)
AVP 模型详细评测
双臂臂型排名 5 / 31 · 截至 2026.07.14

基于自采 piper + DOS-W1 跨本体混训,从数据扩充、训练策略、测试时增广多维度持续迭代。
04 / World Action Model · 小米新业务部
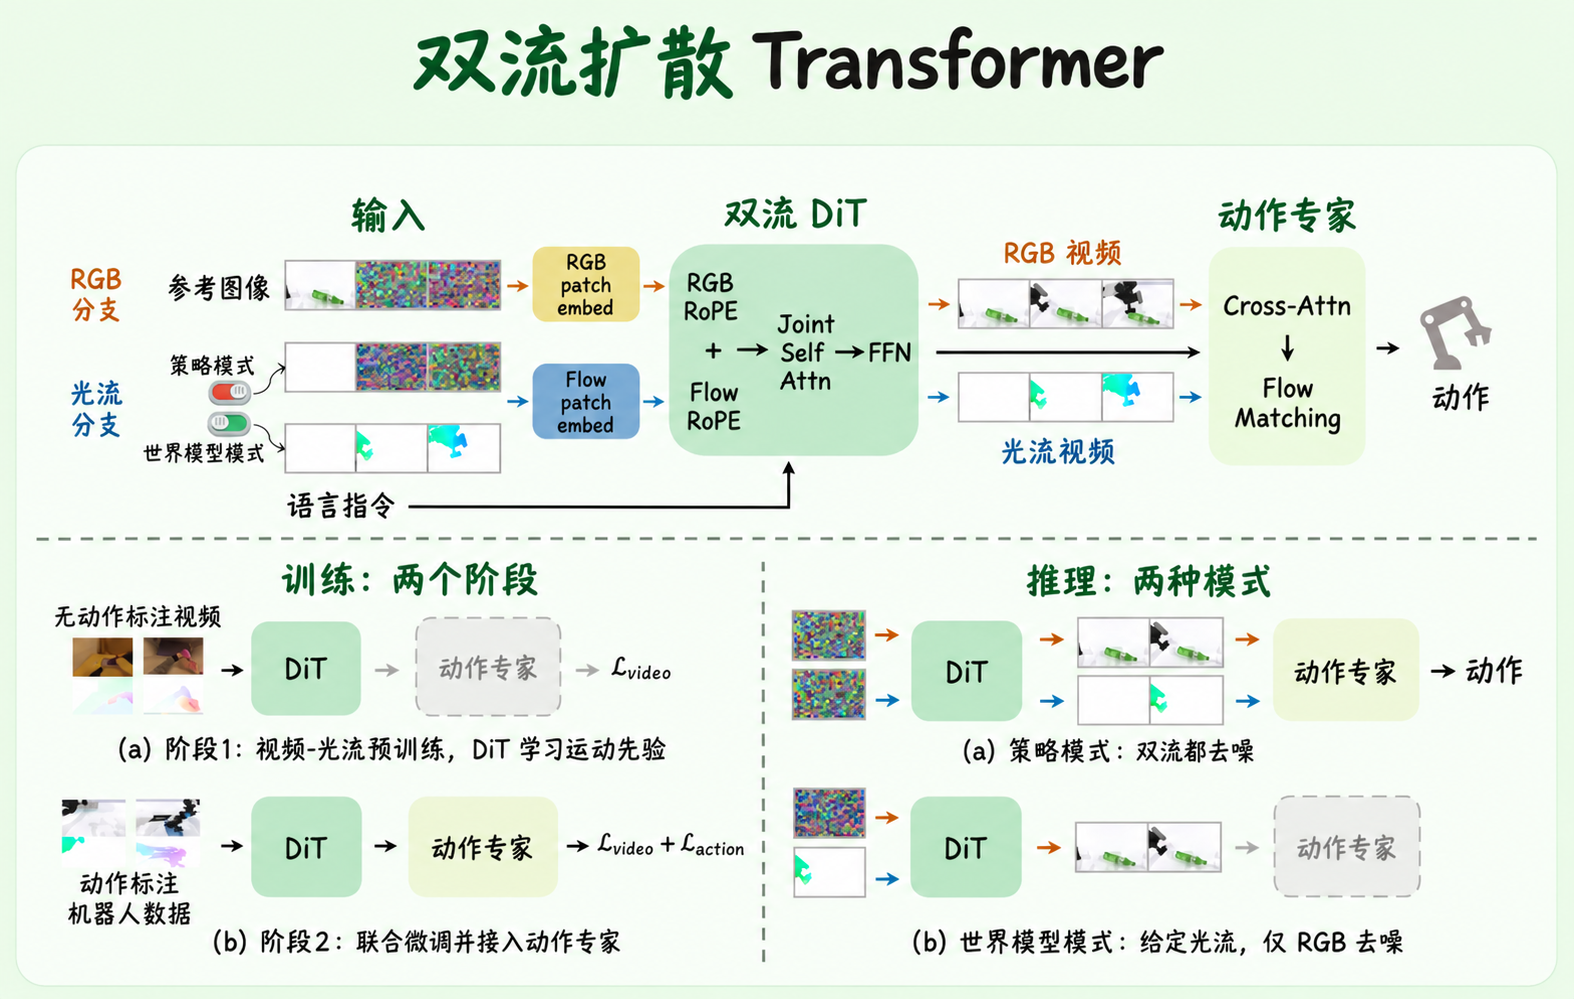
RGB 与光流双流 Transformer 结构及训练、推理模式示意
RGB + Optical Flow 双流结构与训练 / 推理模式示意

双流 WAM 世界模型

基于 Wan2.2-TI2V-5B 构建 RGB 与 Optical Flow 双流 DiT,引入显式运动先验,结合文字与本体状态条件,进行动作驱动的未来场景生成。

5 / 30WorldArena 2.0 · Track1
120 帧未来视觉场景预测
Wan2.2 / DiTRAFT Optical FlowSeedVR2
深入了解 WAM:双流模型、光流数据构建与比赛结果

任务:预测未来 120 帧视觉场景

输入首帧 RGB + 动作轨迹 + 文字指令,世界模型预测未来场景(PSNR / SSIM / LPIPS / FVD)。基础模型 Wan2.2-TI2V-5B,引入光流作为显式 Motion Prior。

原实验结构:RGB 分支 + Flow 分支,注入 Text / Proprio 条件,经过 30 层 Joint Self-Attention 生成未来帧。
双流 WAM 模型结构与训练、推理模式示意
双流 WAM:RGB 与 Flow 分支、条件注入及训练 / 推理模式示意

RGB–Optical Flow 双流 DiT

Flow 数据流(训练)
robot-only 视频
仿真单独渲染
→
RAFT 光流
逐帧对
→
HSV 编码
方向=色相
速度=饱和
→
robot mask
只留臂部运动
→
同 VAE
编码 latent
  • RGB 分支:处理外观语义,Cross-Attention 注入文字(UMT5)+ 14D 本体状态(→MLP→121 token)
  • Flow 分支:独立 patchify + RoPE,与 RGB token 拼接后联合过 Self-Attention
  • 训练用 GT Flow,推理置零:靠训练学到的"动作→运动"隐式映射生成画面
  • 后处理:SeedVR2 超分 + 时序下采样(121→40/20 帧)提升画质
WorldArena 2.0 Track1 排名结果
WorldArena 2.0 · Track1 排名 5 / 30

超过 25 支参赛队伍,Track1 排名第 5。光流显式编码机器人运动场,比让 RGB 隐式学运动更高效。

04 / 项目经历

项目经历

访问 GitHub 主页
01 / ROBOT MANIPULATION

GraspFruit · 自主水果抓取

VLM + 分割 + 6DoF 抓取的端到端闭环系统,MuJoCo 仿真验证。
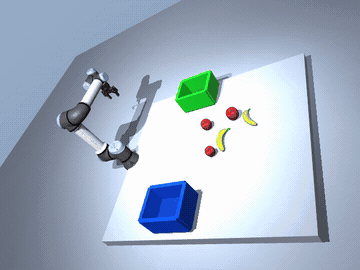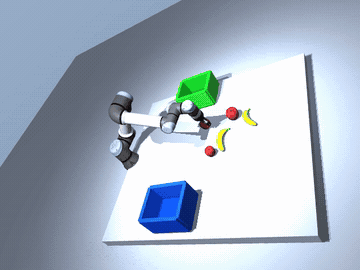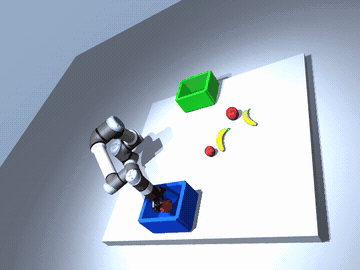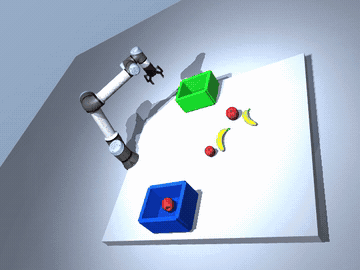
Qwen-VL
语义规划
→
SAM3
实例分割
→
GraspNet
6DoF 抓取
→
MuJoCo
执行验证
演示:苹果分拣到蓝色篮子
Qwen3-VLSAM3GraspNetUR5e+2F-85ROS2
02 / VISUAL MEMORY

LeMEM · VLA 记忆模块

为 VLA 模型设计的轻量级多尺度视觉记忆模块,将短期历史观测融入策略网络,提升长时序任务的时序一致性。开源实现,含完整训练/评测框架。
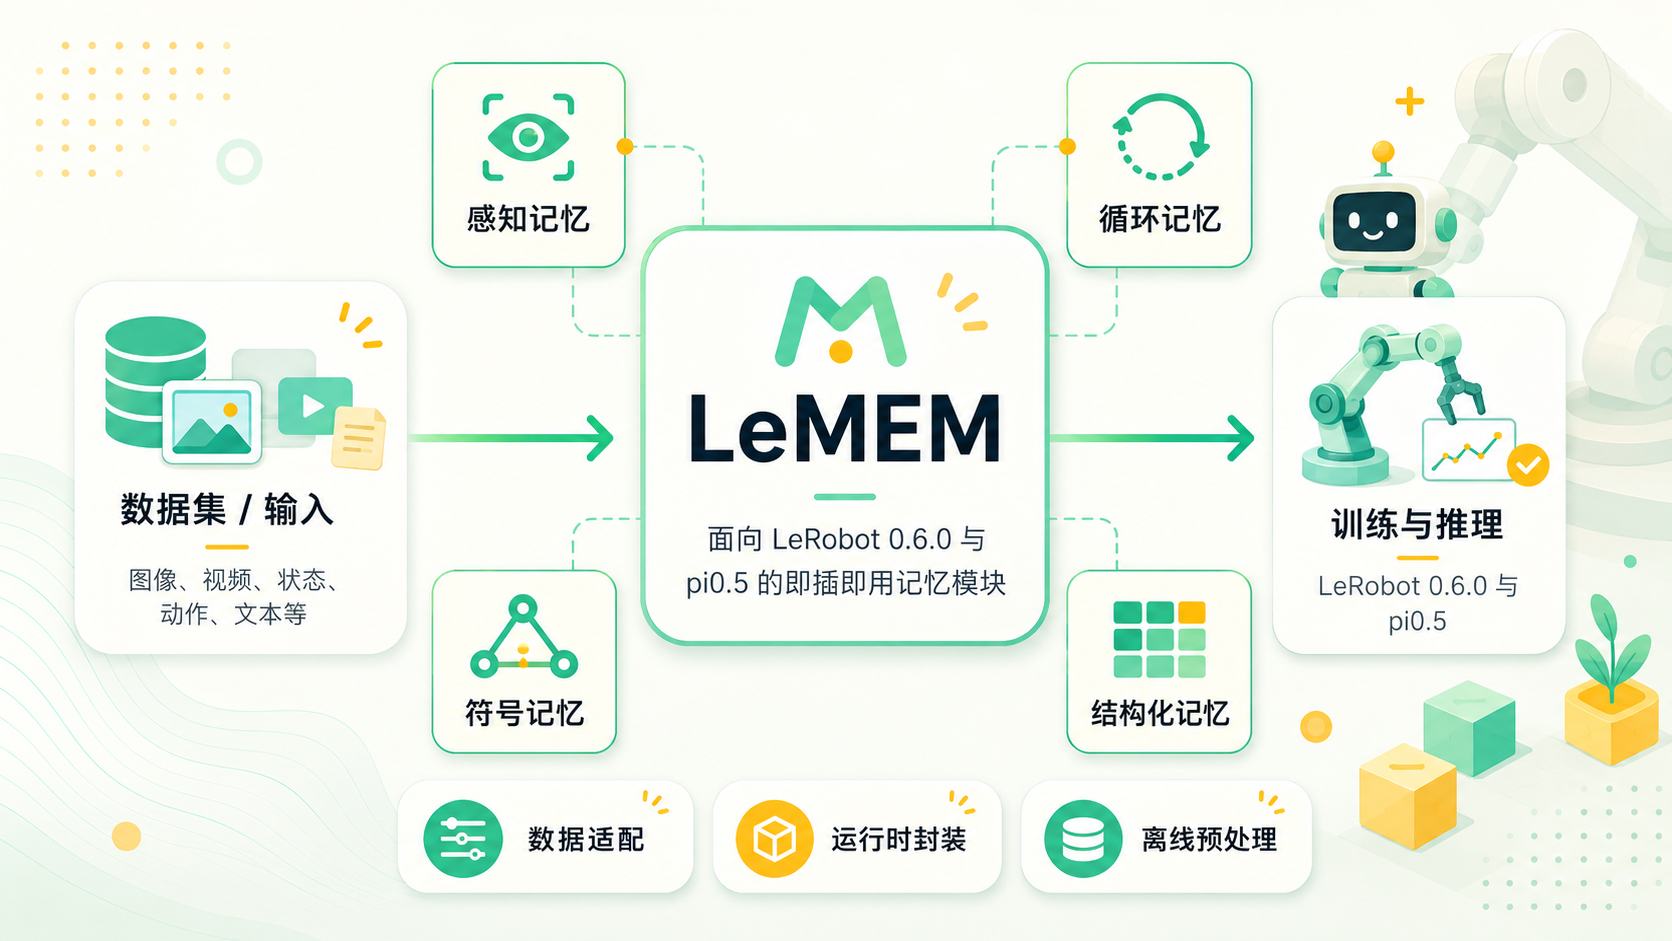
LeMEM 架构:多尺度记忆注入 VLA backbone
π0.5SigLIPTemporal-AttnPyTorch
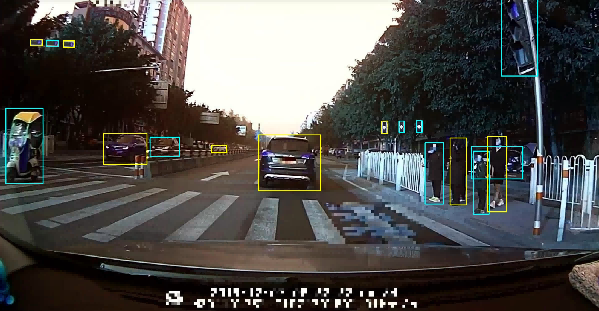
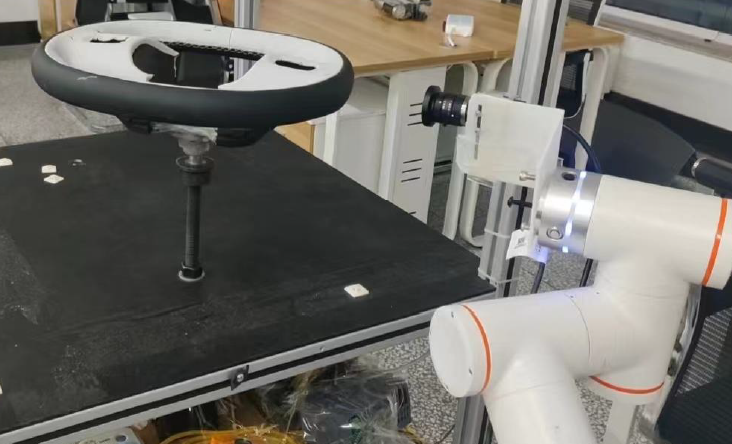
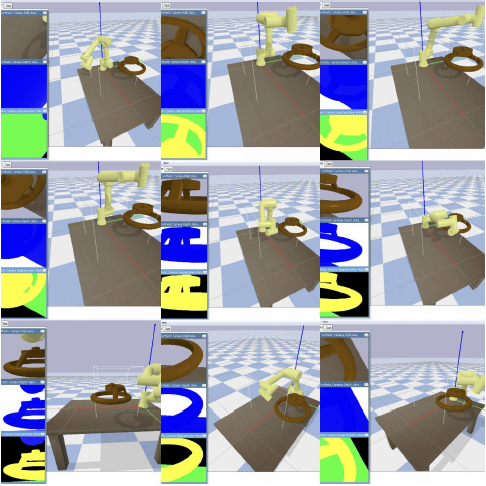
查看本科机器人实践与智能车竞赛现场

本科代表性技术经历

目标检测:车辆/行人感知
真实双臂机械臂操作
MuJoCo 仿真操作环境
第17届全国大学生智能汽车竞赛(全国一等奖 · 百度智慧交通组)
本科项目与竞赛

本科阶段参与车辆 / 行人目标检测、真实双臂机械臂操作与 MuJoCo 仿真,在全国大学生智能汽车竞赛百度智慧交通组获得全国一等奖。

05 / 专业技能

专业技能

具身多模态大模型

Qwen3-VLSAM3YOLOGraspNetGCR LossEDASFT / LoRADeepSpeed ZeRO

仿真 & 强化学习

MuJoCoIsaac SimPyBulletA2C / PPO / ACKTRGATMoveIt / OMPLDomain Random.Sim2Real

VLA & WAM 模型

π0.5Flow MatchingFAST TokenKI / MemoryWan2.2 / DiTRAFT 光流SeedVR2跨本体 Co-Train
其他

周苍田

具身智能算法 · VLA / WAM · 多模态模型与机器人学习